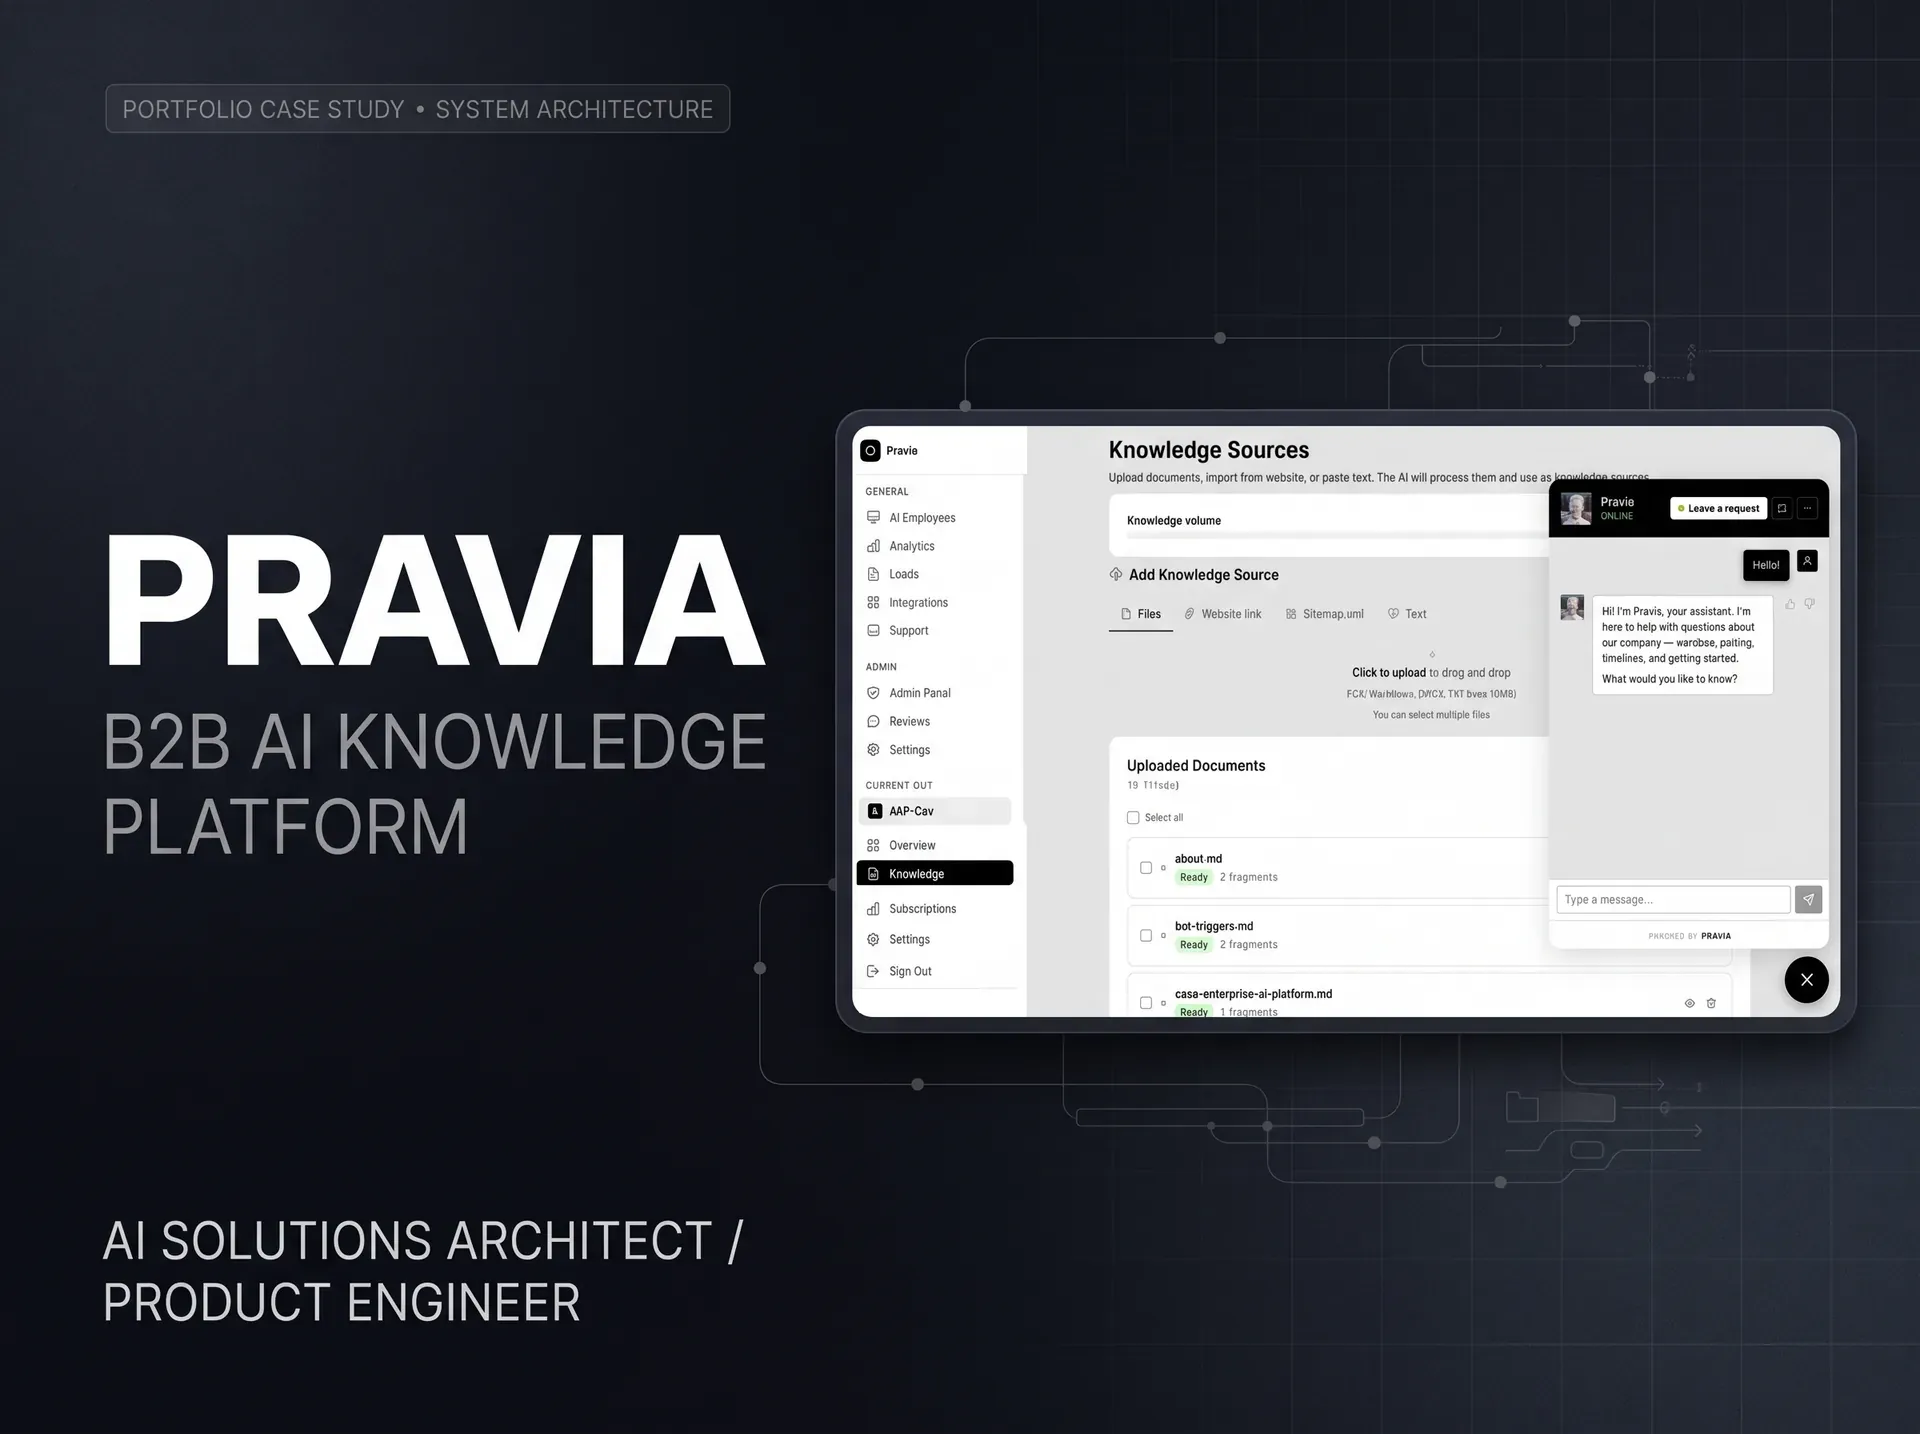
Pravia: B2B-платформа AI-сотрудников на корпоративных знаниях
Высоконагруженная multi-tenant RAG-платформа с локальными эмбеддингами (ONNX) и оптимизацией задержки p95 с 19.7 с до 164 мс под нагрузкой 1 000 VU.
Клиент
Собственный продукт / B2B SaaS
Услуги
Multi-Tenant RAG, pgvector (HNSW), Local ONNX Embeddings, k6 Optimization
Услуга
Задача
Большинство коробочных RAG-решений страдают от сетевого оверхеда внешних API для вычисления эмбеддингов, деградации скорости при одновременных запросах и слабой изоляции данных между разными компаниями. Цель проекта: разработать независимую мультитенантную платформу для создания AI-сотрудников, способных мгновенно отвечать на вопросы клиентов и сотрудников строго по загруженным регламентам, документам и веб-страницам, выдерживая высокие нагрузки без деградации скорости.
Решение
Архитектура Pravia построена на Bun и PostgreSQL с pgvector. Поисковые запросы векторизуются локально на CPU через ONNX Runtime с моделью EmbeddingGemma-300M, что полностью устраняет задержки сетевых вызовов в сторонние облака и снижает инфраструктурные затраты до 90%. Для векторного поиска задействован HNSW-индекс, обеспечивающий субмиллисекундную выборку среди сотен тысяч чанков. Ответы генерируются в потоковом режиме через SSE (Server-Sent Events) для мгновенного Time to First Token (TTFT).
Архитектурная схема пайплайна
┌─────────────────────────┐          SSE Streaming          ┌──────────────────────────┐
│   Web / Telegram Chat   │ ◄────────────────────────────── │   Pravia Response Engine │
└────────────┬────────────┘                                 └────────────▲─────────────┘
             │                                                           │
             │ Текст запроса                                             │ Релевантные чанки
             ▼                                                           │
┌─────────────────────────┐     Векторный поиск (3.2мс)     ┌──────────────────┴─────────────┐
│   ONNX Runtime (CPU)    │ ──────────────────────────────► │   PostgreSQL 16 + pgvector     │
│   EmbeddingGemma-300M   │   Zero-Cloud Векторизация       │   HNSW Index (ef_search = 64)  │
└─────────────────────────┘                                 └────────────────────────────────┘
Сравнение задержки под нагрузкой (k6 Benchmarks)
| Метрика | До оптимизации | После тюнинга HNSW и батчинга | Результат |
|---|---|---|---|
| Задержка p95 (300 VU) | 19.7 с | 164 мс | Ускорение в 120 раз |
| Пропускная способность (1 000 VU) | Сбои соединений | 46 req/s (99.98% OK) | Стабильность без деградации |
| Инфраструктурные затраты | Внешние embedding API | Zero-Cloud CPU ONNX | Экономия до 90% бюджета |
Ключевые особенности
- Zero-Cloud Embeddings: Локальный расчет эмбеддингов на CPU через ONNX Runtime (EmbeddingGemma-300M) без передачи текстов во внешние API.
- pgvector + HNSW: Индексация векторных представлений по алгоритму HNSW с тонким тюнингом параметров ef_search и m для субмиллисекундного поиска.
- Multi-Tenancy & RBAC: Полная криптографическая и логическая изоляция баз знаний, сессий и ролей между разными компаниями.
- Мультиформатный импорт: Автоматический парсинг и индексация веб-сайтов по Sitemap XML, документов PDF, DOCX, Markdown и сырого текста.
- Умный виджет и лидогенерация: Встраивание виджета на любой сайт одной строкой кода, Telegram-бот и автоматическая передача квалифицированных лидов в CRM через Webhooks.
Технологии
Архитектура и развертывание
При первоначальных стресс-тестах задержка p95 достигала 19.7 с из-за блокировок пула соединений БД при синхронной записи аналитики. После десериализации транзакций, выноса логов в асинхронный батчинг и изоляции воркер-пула ONNX под нагрузкой 300 одновременных пользователей задержка p95 снизилась до 164 мс (0% ошибок), а в пиковом тесте на 1 000 VU система стабильно выдержала 46 req/s с 99.98% успешных ответов на одном стандартном VPS.
Другие проекты
Lead Hunter AI — Мультиканальный агент лидогенерации по 30+ каналам
Enterprise RAG — База знаний на 65 000+ чанков с AI Gateway
Понравился инженерный подход?
Спроектируем и запустим надежную систему под задачи вашего бизнеса — от архитектуры до релиза и поддержки.